

Un client m'appelle en panique. Son trafic a chuté de 38 % en trois semaines. Pas d'action manuelle dans la Search Console, pas de lien toxique, pas de refonte. Rien. Après deux jours à éplucher ses URL, la cause saute aux yeux : il a publié le même article sur son blog et sur un média partenaire, avec la même URL canonique pointant vers... nulle part. Deux versions identiques, aucune indication à Google sur celle à privilégier. Il s'est auto-concurrencé pendant huit mois.
Ce genre d'histoire arrive plus souvent qu'on ne le croit. Le contenu dupliqué en SEO n'est pas une pénalité mythique qui frappe les spammeurs : c'est un problème de signal, un problème d'architecture, et dans 90 % des cas que j'ai traités, un problème de balises oubliées.
Points clés à retenir
- Google ne pénalise pas automatiquement : il choisit la version qu'il juge la plus fiable et ignore les autres.
- Quatre causes réelles couvrent l'essentiel des cas : doublons d'URL, syndication, fiches produits, réécriture IA.
- La balise rel="canonical" règle la majorité des situations internes. La redirection 301 règle le reste.
- Un audit de similarité par crawl complet identifie les clusters à traiter en priorité.
- Le contenu généré par IA n'est pas du duplication par défaut — mais 20 reformulations de la même page, si.
Le contenu dupliqué en SEO : ce que Google fait vraiment
Première chose à clarifier, parce que je vois encore des agences vendre des "audits anti-pénalité duplicate content" à prix d'or : Google ne sanctionne pas le duplicate content en soi. Il filtre. C'est très différent.
Le filtre fonctionne comme ça : quand l'algorithme rencontre plusieurs URL avec un contenu quasi identique, il en sélectionne une (la plus ancienne, la mieux liée, la plus complète) et la met en avant dans les résultats. Les autres existent toujours, mais elles sont reléguées. Résultat concret : vous avez cinq pages qui se battent pour la même requête, aucune ne remonte vraiment, et vous avez dépensé cinq fois le budget de production pour un résultat inférieur à celui d'une seule bonne page.
Duplication interne et duplication externe
La distinction est utile parce que les solutions diffèrent.
- Interne : plusieurs URL de votre propre site se ressemblent. Paramètres de tri, versions imprimables, pagination, trailing slash, HTTP vs HTTPS. Vous contrôlez tout.
- Externe : votre contenu apparaît ailleurs. Syndication presse, revendeurs qui recopient vos fiches produits, annuaires, agrégateurs. Vous ne contrôlez qu'une partie.
Et il y a un troisième cas que personne ne mentionne jamais : le duplication sémantique. Deux pages avec des mots différents mais un propos identique. Google sait le détecter depuis longtemps. J'ai vu un site e-commerce avec onze articles "comment choisir son matelas" publiés sur quatre ans par quatre rédacteurs différents. Onze angles quasi identiques, zéro trafic sur les onze.
Pourquoi filtrer plutôt que punir ?
Parce que la duplication est souvent involontaire et parfois légitime. Un site en plusieurs langues a forcément des pages structurellement proches. Un e-commerce avec 300 variantes de couleur du même produit génère mécaniquement des pages similaires. Punir ça serait absurde. Filtrer, en revanche, protège la qualité des résultats sans casser des sites qui fonctionnent normalement.
La vraie question n'est donc pas "est-ce que je vais être pénalisé", mais "est-ce que Google comprend quelle page je veux voir ranker ?". Tout le guide tient dans cette phrase.
Quelles sont les erreurs SEO courantes à éviter ?
En dehors du duplicate content, quatre erreurs reviennent dans presque tous les audits que je réalise, et elles ont un point commun : elles sont invisibles à l'œil nu.
Oublier la canonique sur les pages paramétrées
Un site de location de vacances, 4 200 hébergements, filtres de tri par prix, par date, par nombre de personnes. Chaque combinaison génère une URL. Résultat : 180 000 URL indexables pour 4 200 biens réels. Le crawl budget part en fumée, et chaque bien a une dizaine de versions qui se concurrencent.
La correction tient en une ligne dans le template : <link rel="canonical" href="[URL du bien sans paramètre]">. Trois semaines après le déploiement, le nombre de pages indexées était divisé par douze.
Traiter la pagination comme du contenu unique
Les pages 2, 3, 4 d'une catégorie ne sont pas du contenu dupliqué au sens strict, mais elles diluent les signaux si vous les laissez indexables avec un titre identique. La bonne pratique : un titre qui mentionne le numéro de page, une canonique vers la page elle-même (pas vers la page 1, c'est une erreur fréquente), et éventuellement un noindex, follow sur les pages profondes si elles n'ont aucune valeur de découverte.
Mal configurer les versions multilingues
Sans hreflang, une version française et une version belge quasi identiques sont perçues comme deux duplicatas. Google en choisit une pour tout le monde. J'ai corrigé ça sur un site suisse : trois variantes linguistiques, aucune déclaration, et la version allemande raflait les positions sur les requêtes romandes. Deux semaines après l'implémentation du hreflang réciproque, la version française remontait en tête sur son marché.
Quels sont les 4 piliers du SEO ?
La réponse classique tient en quatre blocs : technique, contenu, popularité (les liens), et expérience utilisateur. Ça semble scolaire, mais cette grille est utile parce qu'elle évite un biais très répandu — croire qu'un problème de trafic est forcément un problème de contenu.
Dans le cas du duplicate content, trois des quatre piliers sont touchés simultanément :
- Technique : l'architecture d'URL et les balises canoniques décident de ce qui est indexé.
- Contenu : la valeur ajoutée réelle d'une page par rapport aux autres décide de ce qui mérite d'être indexé.
- Popularité : si cinq versions d'une page reçoivent chacune deux liens externes, aucune n'atteint la masse critique. Fusionner les versions consolide les signaux.
- Expérience utilisateur : une page canonique claire, c'est aussi une page vers laquelle tous vos liens internes pointent. Moins de clics perdus dans des impasses.
Et si vous ne devez retenir qu'un pilier pour ce sujet précis, prenez le technique. C'est le seul qui corrige le problème à la racine.
Quels sont les 3 piliers du SEO ?
La version condensée existe aussi, et elle est plus opérationnelle dans un contexte de refonte : crawl, indexation, pertinence. C'est la chaîne de traitement de Google, dans l'ordre.
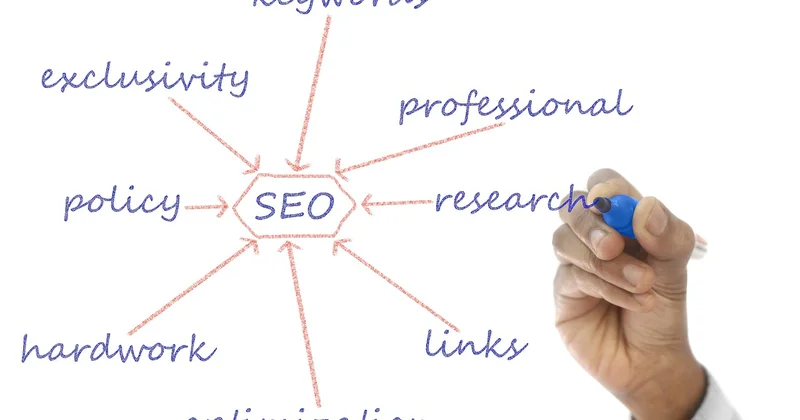
Un contenu dupliqué casse la chaîne à l'étape deux. Le crawl passe (Google trouve les URL), l'indexation filtre (une seule version retenue), et la pertinence se dilue parce que les signaux sont répartis sur plusieurs adresses au lieu d'une.
Comment diagnostiquer chaque maillon
- Crawl : lancez un crawl complet de votre site et exportez la liste des URL avec leur code HTTP. Cherchez les 200 en double, les paramètres inutiles, les chaînes de redirection (301 → 301 → 200, un grand classique).
- Indexation : comparez le nombre d'URL crawlées au nombre d'URL réellement indexées. Un écart supérieur à 30 % sur un site mature mérite une enquête.
- Pertinence : sur vos dix requêtes principales, vérifiez quelle URL ressort. Si ce n'est pas celle que vous voulez voir, le problème est identifié.
Cette séquence prend une demi-journée sur un site de taille moyenne. Elle évite des semaines de corrections au hasard.
Quels sont les 3 types de SEO ?
On distingue généralement le SEO on-page (balises, structure, contenu de la page), le SEO off-page (liens entrants, mentions, autorité) et le SEO technique (crawl, vitesse, indexation, architecture). Trois familles, trois façons différentes de produire du contenu dupliqué.
Ce que chaque type apporte au problème
- On-page : titres identiques sur plusieurs pages, métas dupliquées, textes alternatifs d'images recopiés en masse. Facile à détecter, facile à corriger.
- Off-page : un partenaire qui republie votre article sans canonical, un annuaire qui recopie vos descriptions. Vous ne pouvez pas tout contrôler, mais vous pouvez contractualiser.
- Technique : c'est ici que se joue la vraie bataille. Canoniques, redirections, paramètres, sitemaps. Le levier le plus puissant, et le plus souvent négligé.
Les solutions techniques qui fonctionnent vraiment
Voici les cinq outils à connaître, classés par ordre d'efficacité dans mon expérience.
| Solution | Quand l'utiliser | Effet réel |
|---|---|---|
| Redirection 301 | La page en double n'a plus de raison d'exister | Transfère 90 à 99 % des signaux vers la cible. La solution la plus propre. |
| rel="canonical" | Les deux pages doivent rester accessibles | Indique la version à privilégier. Google peut l'ignorer s'il juge la canonique incohérente. |
| hreflang | Versions multilingues ou multirégionales | Évite la concurrence entre variantes linguistiques. Doit être réciproque, sinon inopérant. |
| noindex, follow | Pages à valeur nulle pour la recherche (fiches filtres, archives) | Retire de l'index sans bloquer le crawl. À manier avec parcimonie. |
| Consolidation éditoriale | Plusieurs articles sur le même sujet | La plus lente, la plus coûteuse, et souvent la seule qui règle le fond du problème. |
Le cas de la syndication et de la réécriture IA
La syndication est le point aveugle de la plupart des sites médias et blogs. Un article repris par un partenaire avec un lien vers l'original, c'est acceptable. Le même article republié en entier, sans lien, sans canonical, c'est une perte sèche. Le contrat doit mentionner la balise canonique pointant vers votre URL. Si le partenaire refuse, exigez au minimum un lien en tête d'article.
Côté IA, le risque n'est pas ce qu'on croit. Une page générée par un modèle de langage n'est pas du duplicate content par essence. Mais dix pages générées sur le même sujet à partir du même prompt le sont, parce que le modèle produit des structures et des formulations très proches. J'ai audité un site qui avait industrialisé la production d'articles de blog : 60 pages publiées en deux mois, 47 avec un taux de similarité supérieur à 70 % entre elles. Aucune n'a jamais dépassé la position 40.
La méthode d'audit que j'utilise
Trois étapes, dans cet ordre. Ne sautez pas la première, c'est celle qui vous fait gagner du temps.
- Cartographier : crawl complet, export des URL, calcul du taux de similarité par paires. Priorisez par volume de trafic à risque, pas par nombre de pages.
- Trancher : pour chaque cluster, une seule décision. Fusionner, rediriger, canonicaliser ou supprimer. Si vous hésitez plus de cinq minutes, c'est que la page n'a pas de valeur claire.
- Surveiller : après correction, vérifiez dans la Search Console que la bonne URL conserve l'indexation. Comptez deux à six semaines selon la fréquence de crawl.
Un détail que j'ai appris à la dure : ne corrigez jamais tout d'un coup sur un gros site. J'ai redirigé 12 000 URL en une nuit sur un client. Résultat, Google a mis six semaines à digérer, avec une chute temporaire de 22 % du trafic organique qui a fait très peur au comité de direction. Par lots de 500, avec un suivi hebdomadaire, ça passe beaucoup mieux.
Le duplicate content n'est pas un fléau qu'on éradique. C'est un bruit qu'on réduit, jusqu'à ce que Google n'ait plus aucun doute sur la page que vous voulez voir gagner. Et cette clarté-là, elle se construit balise par balise.


